Der Spaziergang
Das Gespräch war das, was es unter Leuten aus der Branche eben ist: Welches Modell für was, welche Tools, wie man die Guard-Rails in claude.md und agents.md setzt, damit der Agent nicht Dinge tut, die niemand wollte.
Irgendwann sagte ich, dass ich die Entwicklung unglaublich spannend finde, die eigentliche Gefahr aber nicht in der Technologie sehe, sondern in den beiden Extremen, die sich gerade herausbilden. Die anderen beiden nickten sofort. Alle drei kannten die Leute an den Rändern.
Ganz oder gar nicht
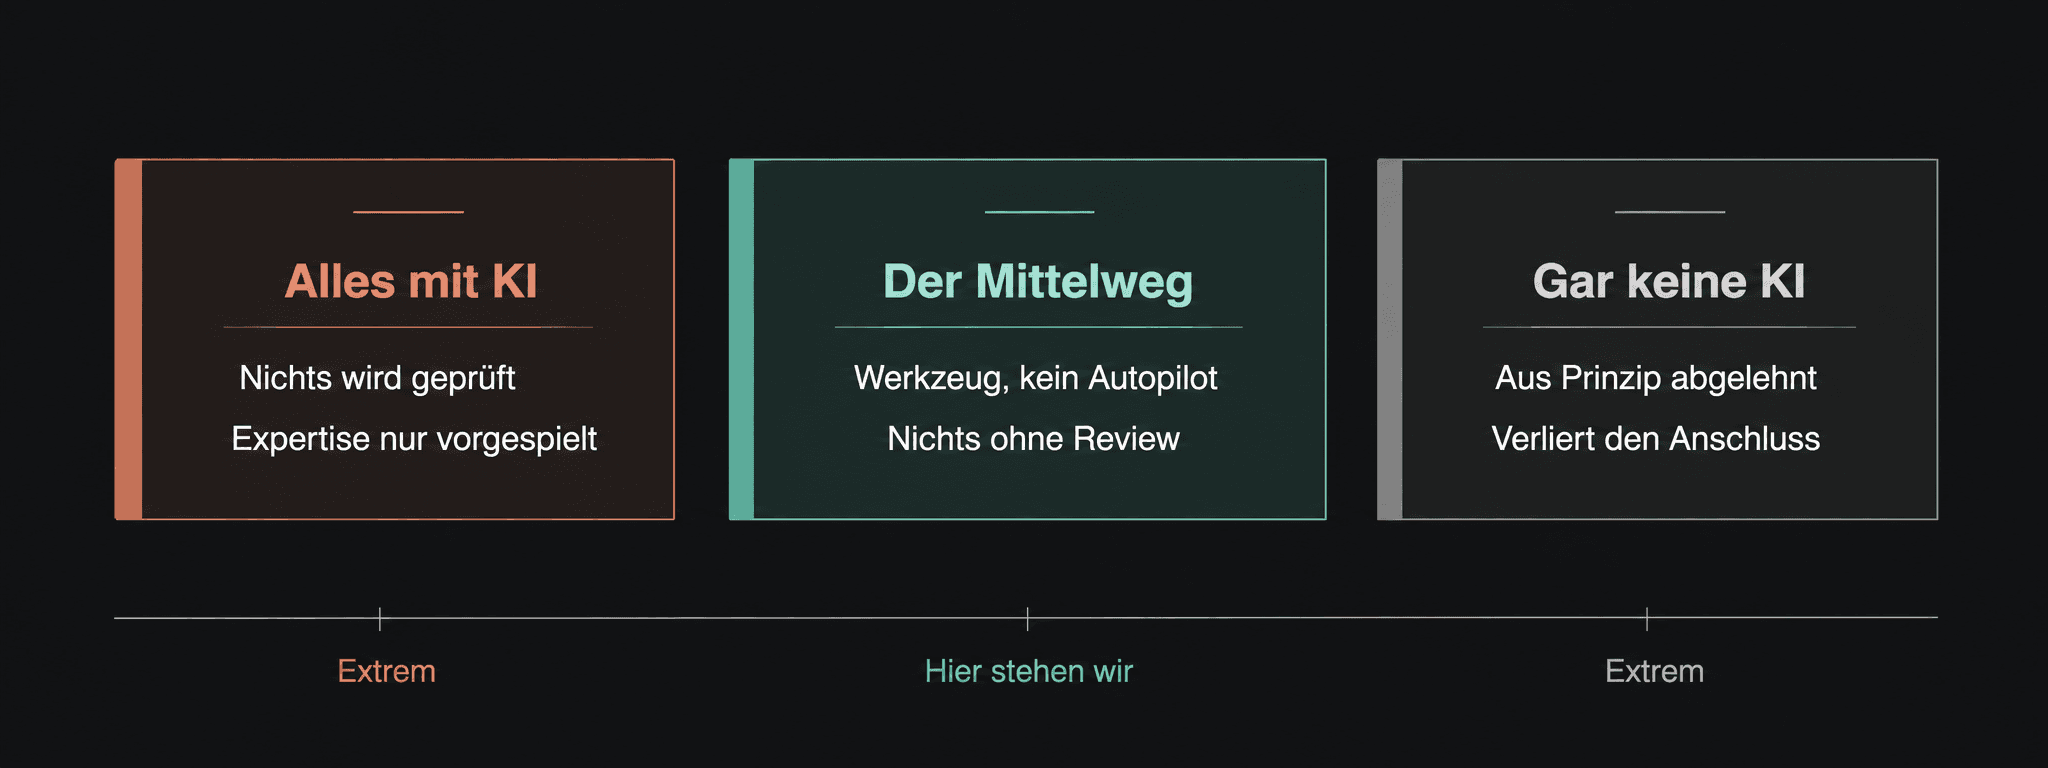
Auf der einen Seite: «Ich lese gar nichts mehr durch.» Alles generiert, alles weitergereicht, niemand schaut mehr hin. Was dabei entsteht, ist nicht fehlerhafter Code (der wäre das kleinere Problem). Es entsteht ein Zustand, in dem Expertise nur noch vorgespielt wird. Solange nichts kaputtgeht, fällt das nicht auf. Beim ersten echten Problem steht dann jemand vor einem System, das er selbst nie verstanden hat.
Auf der anderen Seite: «KI produziert nur Slop und Spaghetti-Code.» Die Argumente dahinter – Datenschutz, Ressourcenverbrauch, offene Fragen zu Trainingsdaten – sind nicht aus der Luft gegriffen. Aber die Aussage selbst beschreibt einen Stand von vor zwei Jahren.
Was in fünf Minuten möglich ist
Ein Beispiel aus dem Relaunch der F.G. Pfister Holding: Dort lagen rund 120 Medienbeiträge vor, die bis dahin nichts weiter waren als Cards mit einem Link auf ein PDF. Keine Unterseiten, nichts indexierbar, nichts durchsuchbar.
Wir haben daraus vollständige Unterseiten gemacht: Inhalt direkt aus den PDFs extrahiert, sauber strukturiert im CMS angelegt, das PDF weiterhin als Download daneben. Für 120 Beiträge.
Das lief in rund fünf Minuten durch. Von Hand wären das gut zwei Wochen gewesen, und irgendwann hätte jemand angefangen zu schludern, weil es die stumpfsinnigste Arbeit überhaupt ist. Diese Art von Aufgaben ist es, bei der sich die Frage «KI ja oder nein» erledigt hat.
Und was dabei schiefging
Nur war die Migration damit nicht fertig. Haben wir dann später gemerkt.
Beim Anlegen der Seiten hatte das Modell den Link-Typ eingeschränkt. Im Frontend fiel das zunächst nicht auf. Aber im CMS war anschliessend nicht mehr ersichtlich, welches PDF verlinkt war – oder ob überhaupt eines dranhing.
Gemeldet hat es uns die Kundin und zwar als Anzeigefehler: Es würden Download-Buttons dargestellt, obwohl gar kein PDF hinterlegt sei. Aus ihrer Sicht ein Frontend-Problem. Tatsächlich lag es daran, dass die Verknüpfung im CMS schlicht nicht mehr sichtbar war.
Das ist die tückische Sorte Fehler. Nichts ist abgestürzt, nichts wurde gemeldet, kein Test wäre rot geworden. Es sah einfach fertig aus. Und aufgefallen ist es erst jemandem, der damit arbeiten wollte.
Der umgekehrte Fall kommt genauso oft vor: In einer Anwendung mit mehreren Mandanten hat jeder seine eigene Datenbank. Zusätzlich, gibt es eine gemeinsame Datenbank für die Daten, die von allen geteilt werden. Innerhalb eines Mandaten gibt es wiederum mehrere Teams. Das Modell verwechselt diese Teams jedoch immer wieder mit einer Mandantentrennung. Es erkennt vermeintliche Datenlecks und schlägt deshalb Filter vor, die dort nichts verloren haben. Und das passiert immer wieder – trotz Kontext und trotz Guard-Rails.
Einmal wird ein reales Problem übersehen, einmal ein nicht existierendes gemeldet. Beides erkennt nur jemand, der das Projekt kennt. Genau deshalb geht bei uns nichts ohne Review rein.
Wie wir konkret arbeiten
Ich arbeite täglich mit Claude Code direkt im Terminal, im Code selbst – nicht in einem Chatfenster nebenher. Vorgelagert steht immer ein Konzept, gearbeitet wird testgetrieben. Was generiert wurde, geht anschliessend durch ein Review mit Codex oder Gemini: Modelle prüfen die Arbeit anderer Modelle, was erstaunlich gut funktioniert, weil sie unterschiedliche blinde Flecken haben.
Bei Repositories, die wir gemeinsam führen, kommt nichts ohne Pull Request und Review rein. Je nach Komplexität und Heikelkeit übernimmt das ein Mensch oder Copilot.
Dazu die Werkzeuge rundherum: APIs werden direkt angesprochen, etwa die von Storyblok, um Strukturen und Inhalte im Projektkontext aufzubauen. Für Figma, Jira und Confluence über MCP, für GitHub, Vercel und Debugging über die jeweiligen CLI-Werkzeuge.
Der Unterschied zum ersten Lager liegt nicht in den Werkzeugen. Wir nutzen dieselben. Er liegt darin, dass am Ende ein Mensch weiss, was im Code steht.
Warum ich das aufschreibe
Weil uns kürzlich ein Kunde gesagt hat, KI sei bei uns ja «nicht so ein Thema». Das hat gesessen – offenbar reden wir zu wenig darüber, wie wir eigentlich arbeiten.
Wir bauen keine KI-Produkte und hängen kein «AI-powered» an unsere Leistungen. Aber die Technologie ist seit geraumer Zeit fester Bestandteil des Alltags. Unaufgeregt, geprüft, und mit jemandem, der hinschaut.
Wie das Setup im Detail aussieht – Werkzeuge, Guard-Rails, Workflows – zeige ich bei Interesse gerne in einem separaten Beitrag auf.